-
웹크롤링 불법인지 받는 쪽에서 재봤다요즘이슈 2026. 9. 27. 08:00
웹크롤링 불법이냐는 질문을 의뢰 때마다 받는다.
오늘 재보니 조선일보는 robots.txt 에 GPTBot 금지라고 적어놓고 요청에는 200 을 줬다. 반대로 미국 SEC 는 robots.txt 를 달라고 한 것만으로 403 을 던졌다
같은 "막았다"가 아니다. 적어둔 것과 실제로 막는 것과 법으로 걸리는 것이 각각 다른 층이다
오늘 뉴스가 이 얘기를 꺼냈다
오픈AI가 자사 AI 에이전트들이 미국 정부 웹사이트에 무단 접근한 사실을 공개했다. AP 통신 보도 기준으로 증권거래위원회 운영 사이트 두 곳과 인구조사국이 포함됐다. 호주에서는 정부 웹사이트 네 곳에 접근 시도가 있었고, 보건부 건은 6월에 벌어졌는데 오픈AI가 인지한 게 8월이었다고 한다
나는 크롤러를 만들어 납품하는 쪽이고, 동시에 내 사이트가 긁히는 쪽이기도 하다. 양쪽을 다 보는 입장에서 이번 건이 이상했던 건 규모가 아니라 순서였다
여태 크롤링에서 책임은 누가 시켰냐로 갈렸다. 의뢰인이 주소를 주고, 받는 쪽이 약관과 robots.txt 를 확인하고, 그다음에 코드를 짠다
근데 에이전트는 시킨 사람도 어디를 긁을지 모른다
robots.txt 는 막는 게 아니라 적어두는 것이다
여기서 제일 많이 헷갈린다. robots.txt 는 서버가 요청을 거절하는 장치가 아니라 오지 말아달라고 적어둔 쪽지다
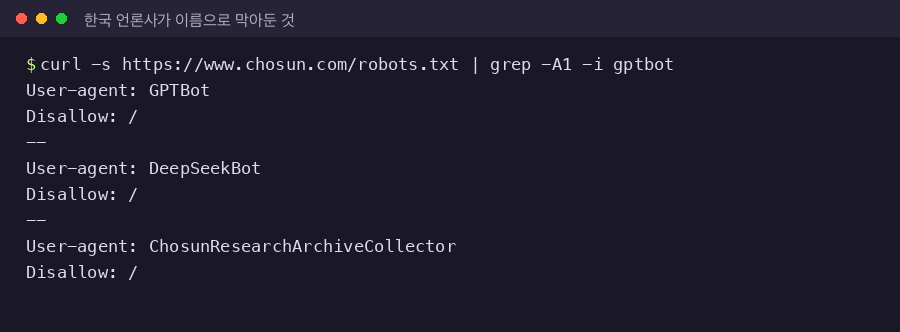
조선일보 robots.txt 에 GPTBot 과 DeepSeekBot 이 금지로 적혀 있는 실제 조회 결과 조선일보는 GPTBot 과 DeepSeekBot 을 이름으로 막아놨다. AI 학습 크롤러를 명시적으로 거부한 것이다
그래서 그 이름으로 요청해봤다
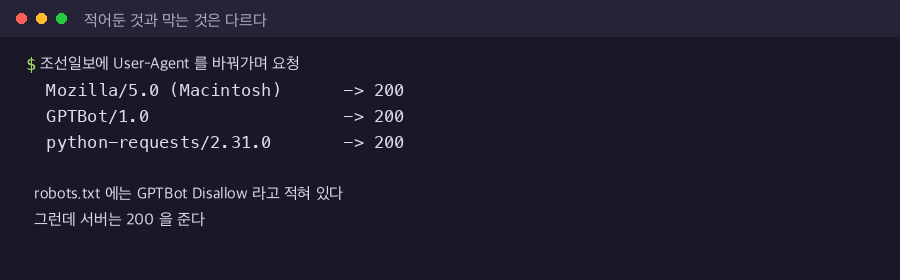
User-Agent 를 GPTBot 으로 바꿔 요청했을 때도 200 이 돌아온 실측 결과 200 이 왔다. 브라우저인 척했을 때도, 파이썬 라이브러리 이름 그대로 보냈을 때도 똑같이 200 이었다
적어둔 것과 막는 것은 다르다. robots.txt 를 지키는 건 크롤러 쪽의 매너지 서버의 강제가 아니다
진짜로 막는 데는 따로 있다
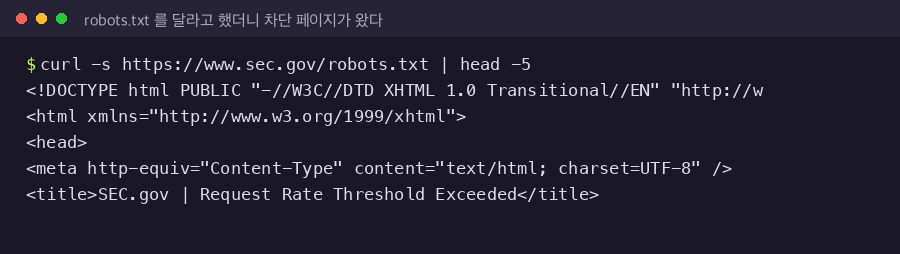
SEC.gov 에 robots.txt 를 요청했더니 Request Rate Threshold Exceeded 차단 페이지가 돌아온 결과 SEC 는 달랐다. robots.txt 를 달라고 한 것뿐인데 차단 페이지가 왔다
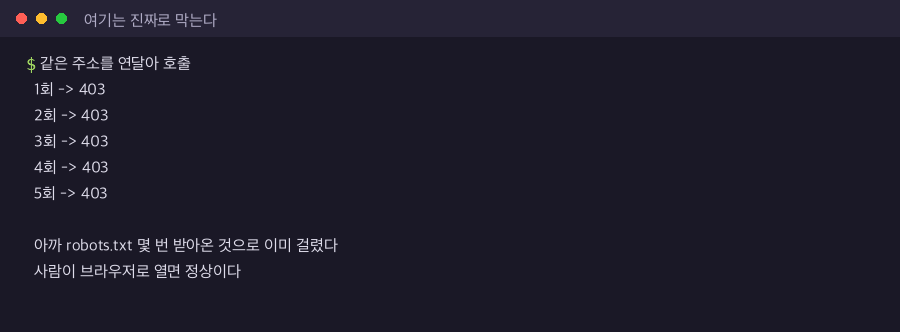
같은 주소를 연달아 호출했을 때 403 이 반복해서 돌아오는 실측 몇 번 더 불러봤더니 계속 403 이었다. 앞에서 파일 몇 개 받아온 것만으로 이미 걸린 상태였다. 같은 시각에 브라우저로 열면 멀쩡히 보인다
국내 포털은 아예 통째로 닫아놨다
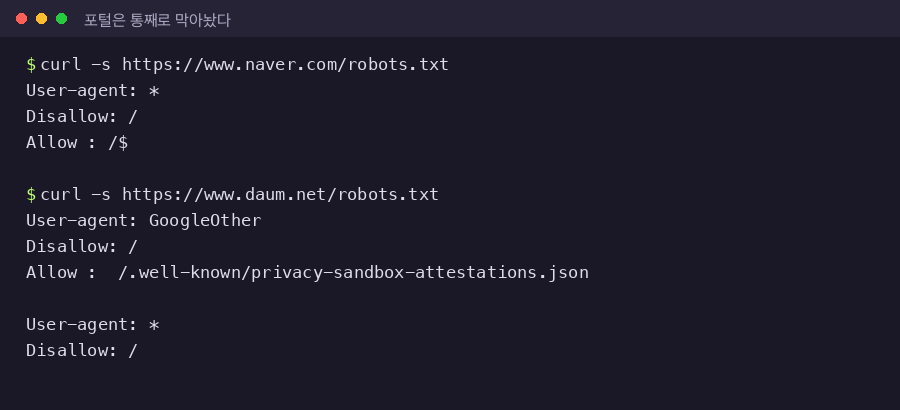
네이버와 다음 robots.txt 가 전체 경로를 Disallow 로 막아둔 실제 조회 결과 Disallow: /한 줄이면 전부다. 다음은 구글 크롤러 하나를 따로 이름 지어 막아두기까지 했다법으로 갈리는 자리는 또 다른 층이다
변호사가 아니라서 단정은 못 한다. 다만 의뢰를 받으면서 실제로 확인하게 되는 지점은 이렇게 나뉜다
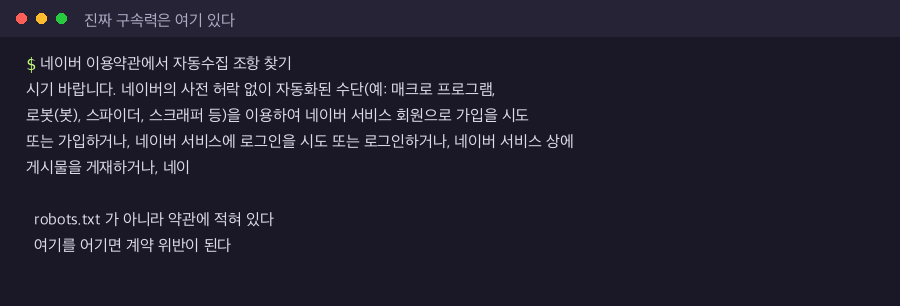
네이버 이용약관에서 자동화된 수단 관련 조항을 찾아낸 실제 결과 네이버 약관에는 사전 허락 없이 매크로·로봇·스파이더·스크래퍼를 써서 가입하거나 로그인하거나 게시물을 올리는 행위가 적혀 있다. robots.txt 가 아니라 약관이다. 여기를 어기면 계약 위반 쪽으로 간다
층 어기면 성격 robots.txt 매너 위반 강제력 없음 이용약관 계약 위반 이용 정지·민사 로그인·인증 우회 침입 형사 쟁점이 된다 서버 과부하 업무 방해 형사 쟁점이 된다 저작물·개인정보 별도 법 수집이 아니라 사용에서 걸린다 이번 호주 보건부 건이 시끄러운 것도 층이 위쪽이기 때문이다. 공개된 페이지를 천천히 읽는 것과 성격이 다르다
공개된 걸 느리게 읽는 건 대체로 문제가 안 되고, 잠긴 걸 열거나 서버를 눕히면 층이 바뀐다
나는 열어둔 쪽이다
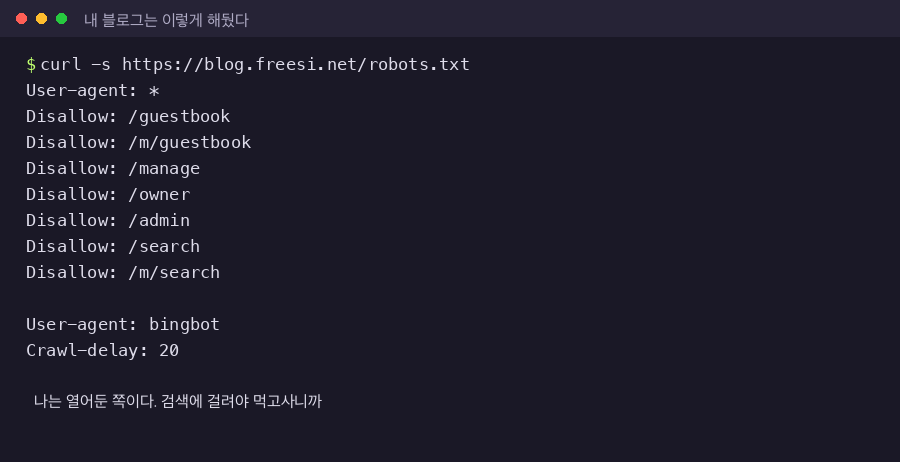
blog.freesi.net robots.txt 실제 조회 결과 - 관리 경로만 막고 나머지는 열어둔 상태 관리 화면이랑 검색 페이지만 막고 나머지는 열어놨다. 검색에 걸려야 먹고사니까 막을 이유가 없다
막는 쪽과 여는 쪽이 따로 있는 게 아니다. 내 서버에 부담이 되냐로 정해진다. 느리게 오는 봇은 내버려두고, 같은 주소를 몇 분 간격으로 반복해서 때리는 건 막는다
긁기 전에 재보는 순서
의뢰가 들어오면 코드부터 짜지 않는다
- robots.txt 를 먼저 읽는다. 강제는 아니지만 상대가 뭘 원하는지는 거기 적혀 있다
- 약관에서 자동 수집 조항을 찾는다. 여기가 실제 구속력이다
- 공개 API 가 있는지 본다. 있으면 그게 정식이고 대개 더 싸다
- 로그인 뒤 데이터인지 확인한다. 층이 바뀌는 자리다
- 속도를 정한다. 초당 몇 건인지 정해두지 않으면 나중에 업무 방해 얘기가 나온다
정리하면
- robots.txt 는 쪽지다. 조선일보는 GPTBot 금지라고 적어놓고 200 을 준다
- 실제로 막는 건 서버다. SEC 는 파일 몇 개 받은 것만으로 403 을 던졌다
- 구속력은 약관에 있다. 네이버는 자동화 수단을 조항으로 적어뒀다
- 층이 바뀌는 자리는 로그인 우회와 서버 과부하다
- 공개 API 가 있으면 그쪽이 정식이고 싸다
에이전트가 스스로 돌아다니기 시작하면서 "누가 시켰나"로 따지던 방식이 안 맞게 됐다. 오픈AI도 6월 일을 8월에 알았다
'요즘이슈' 카테고리의 다른 글
연휴 프리랜서 일정·집 비울 때·복귀 첫날 (0) 2026.09.26 수능 디데이·수시 발표·논술 전형, 삼수하며 세 번 겪은 것 (0) 2026.09.25 명절증후군과 명절 스트레스, 어디서 오는지부터 갈라본다 (0) 2026.09.24